Referensintervall i klinisk kemi: direkt, indirekt och verifiering
En genomgång av överföring, direkt etablering och indirekt skattning av referensintervall, med namngivna indirekta metoder, laboratoriets ansvar enligt ISO 15189 och metodernas begränsningar.
Kan vi använda ett referensintervall som redan finns, eller behöver vi ta fram egna gränser? Ett befintligt intervall kan överföras och verifieras lokalt. Nya gränser kan etableras direkt från definierade referensindivider eller skattas indirekt ur laboratoriedata som samlats in för andra ändamål. Vilken väg som passar beror på vad laboratoriet behöver ta reda på. Oavsett tillvägagångssätt behöver vi också ta hänsyn till dess felkällor.
Artikeln bygger på CLSI EP28-A3c [1], IFCC C-RIDL:s rekommendationer [3], den översikt av Olthof m.fl. som ligger till grund för denna genomgång [4], jämförande studier [8, 11–13] och metodartiklar [9, 10, 18–20]. Ett ackrediterat laboratoriums skyldigheter i fråga om referensintervall följer däremot av ISO 15189:2022, som Swedac tillämpar vid ackreditering av medicinska laboratorier [14–17]. Alla räkneexempel gäller en påhittad analyt X utan kliniska gränsvärden. Figurerna är syntetiska undervisningsmodeller.
| Fråga | Tillvägagångssätt | Vad slutsatsen gäller |
|---|---|---|
| Kan vi använda ett redan framtaget intervall? | Överföring och lokal verifiering | Det föreslagna intervallets användbarhet hos oss, under angivna villkor [1, §10–11]. |
| Var ligger gränserna hos definierade referensindivider? | Direkt etablering | Percentiler skattade från personer som bedömts mot referenskriterier [1, §4, §6–9]. |
| Kan en referensfördelning urskiljas ur rutindata? | Indirekt skattning | Modellberoende gränser ur en blandning av icke-patologiska och sjukdomspåverkade resultat [3]. |
Vad intervallet beskriver
Ett tvåsidigt referensintervall avgränsas vanligen av 2,5:e och 97,5:e percentilen i referensvärdenas fördelning. Ibland är bara en gräns medicinskt relevant, oftast den övre [1, §9]. Referensindivider väljs enligt uttalade kriterier, och gränserna beskriver deras värden [1, §4.2]. Omkring 5 % av referenspopulationens värden ligger utanför ett sådant centralt 95-procentigt intervall. Ett värde utanför är alltså ingen diagnos, och ett värde innanför är inget friskintyg.
Konfidensintervallet (KI, vanligen 90 % eller 95 %) kring varje gräns beskriver hur osäker skattningen av gränsen är. Det beskriver alltså inte spridningen i populationen. KI förutsätter oberoende observationer och en representativ referensgrupp [1, §9.5]. Som jag ser det kan ett smalt KI alltså inte tas som bevis för att referensgruppen var representativ.
Referensintervall är inte kliniska beslutsgränser. Enligt EP28-A3c är referensintervall statistiskt definierade och beskriver en population. Beslutsgränser fastställs i stället genom konsensus och används exempelvis för att bedöma sjukdomssannolikhet eller risk. Finns nationella eller internationella konsensusbaserade beslutsgränser bör dessa rapporteras i stället för referensintervall. För samma analyt rekommenderar CLSI att antingen beslutsgränser eller referensintervall anges, inte båda [1, §12.2.1]. Beslutsgränser bestäms oftast utifrån patienters utfall eller behandlingsrespons [3].
Krav, riktlinjer och forskning
När vi väljer referensintervall behöver vi hålla isär vad som är ackrediteringskrav, vad som är råd om metoder och vad forskningen visar. Tabellen visar vad varje källa säger och vem den gäller för.
| Källa | Typ | Vad den anger om referensintervall | Vem den gäller |
|---|---|---|---|
| STAFS 2020:1 [14] | Swedacs föreskrift | Ackreditering sker mot harmoniserade standarder och tillämpliga tilläggskrav; organet ska visa att kraven uppfylls (§3, §9). Reglerar ackrediteringen, inte beräkningen av intervall. | Organ som ansöker om eller har ackreditering från Swedac (§1) |
| SS-EN ISO 15189:2022 [15–17] | Kravstandard för medicinska laboratorier | När de behövs för tolkningen: fastställa, dokumentera, granska och kommunicera biologiska referensintervall och kliniska beslutsgränser (§7.3.5 enligt PJLA:s återgivning [17]). | Laboratorier som ackrediteras mot standarden |
| CLSI EP28-A3c [1] | Riktlinje | Metodråd, till exempel för allmän icke-parametrisk praxis minst 120 godtagbara värden per partition efter uteslutningar, samt 20+20-regeln för lokal verifiering (validering av överföringen i §11.2). | Ingen skyldighet i sig; metodstöd |
| IFCC C-RIDL [3] | Kommittéutlåtande | Rekommendationer för indirekta metoder. | Rådgivande |
| Metod- och jämförelsestudier [8–13, 18–20] | Forskning | Metodernas egenskaper under angivna villkor. | Evidens, inte krav |
ISO 15189:2022, avsnitt 7.3.5. ISO:s katalogpost anger titel och utgåva [16]. Beskrivningen nedan bygger på ackrediteringsorganet PJLA:s offentliga checklista för standarden (tryckt s. 17) [17]. Checklistan återger kraven i §7.3.5 och är inget svenskt regelverk. Enligt återgivningen ska laboratoriet fastställa och kommunicera biologiska referensintervall och kliniska beslutsgränser till användarna när de behövs för att tolka undersökningsresultat. Dessutom ska det:
- (a) fastställa intervallen och beslutsgränserna och dokumentera deras underlag så att de speglar laboratoriets patientpopulation, med hänsyn till risken för patienterna. En anmärkning medger att tillverkarens biologiska referensvärden används, om laboratoriet har verifierat deras populationsunderlag och bedömt det som godtagbart;
- (b) granska intervallen och beslutsgränserna periodiskt och kommunicera ändringar;
- (c) vid ändrad analytisk eller preanalytisk metod granska hur intervall och beslutsgränser påverkas och, när det är tillämpligt, kommunicera detta.
Punkt (d) gäller undersökningar som påvisar närvaro eller frånvaro av en egenskap, till exempel genetiska undersökningar, och behandlas inte här.
Vad punkten inte anger. Enligt samma återgivning föreskriver §7.3.5 inget minsta antal referensindivider, ingen 20+20-regel, ingen fördelning, ingen viss indirekt algoritm och ingen granskningsfrekvens [17]. Slutsatsen gäller §7.3.5 så som punkten återges i checklistan. Talen 120 och 20+20 är CLSI:s [1, §9.1, §11.2]. CLSI beskriver hur laboratoriet kan arbeta statistiskt för att få underlag för sina intervall. Att använda riktlinjen som metodstöd gör den däremot inte till lag eller ISO-krav. IFCC-gruppens utlåtande [3] och forskningen är ytterligare underlag för metodvalet. Punkt (b) lämnar öppet hur ofta granskningen ska ske. Jag rekommenderar att laboratoriet bestämmer en granskningsfrekvens och dokumenterar den.
Svensk ackreditering. Swedac anger ISO 15189 som tillämplig standard vid ackreditering av medicinska laboratorier och listar för klinisk kemi SS-EN ISO 15189:2022 och STAFS 2020:1 [15]. Föreskriften gäller organ som ansöker om eller har beviljats ackreditering av Swedac (§1). Swedac ackrediterar mot harmoniserade standarder och de ytterligare tillämpliga krav som myndigheten förtecknar på sin webbplats (§3), och den som söker eller har ackreditering ska visa att kraven uppfylls (§9) [14]. STAFS 2020:1 reglerar alltså ackrediteringen. Den är ingen allmän lag för alla kliniska laboratorier, och de återgivna paragraferna anger inte hur referensintervall ska beräknas. Föreskriften och Swedacs förteckning gör standarden till grund för ackrediteringen. Genom standarden får laboratoriet ansvar för intervallen. CLSI, IFCC och forskningen ger sedan underlag för hur laboratoriet kan ta det ansvaret i praktiken.
Direkt eller indirekt: vad som avgör
EP28-A3c skiljer mellan två direkta tekniker. Vid a priori-urval tillämpas kriterierna före provtagning och vid a posteriori-urval efteråt [1, §4.2, §7.4]. IFCC-gruppen beskriver indirekt skattning som att en referensfördelning urskiljs statistiskt ur blandade data utan individuell klassning av varje resultat [3]. Med den definitionen räcker det inte att veta när data samlades in för att avgöra om metoden är direkt eller indirekt.
CLSI nämner blodgivare och hälsoundersökta som relativt friska databasgrupper, möjligen lämpligare än samtliga patienter för indirekt teknik [1, §7.4.2]. Samma data kan användas direkt a posteriori om varje person bedöms mot referenskriterier. CLSI räknar dock även databasstudier med efterhandsfiltrering till indirekt teknik [1, §7.4.2]. Jag tolkar det som att givarkriterier inte nödvändigtvis är referenskriterier. I redovisningen behöver det därför stå var data kommer ifrån, hur personerna har bedömts individuellt och hur den statistiska skattningen har gjorts.
Överföring och verifiering
För att överföra ett intervall behöver laboratoriet först bedöma originalstudien. Den måste vara korrekt utförd, och det egna analyssystemet, populationen och de preanalytiska förhållandena måste vara jämförbara med originalstudiens [1, §10, §10.2]. Intervallet i tillverkarens metodblad är ett förslag att bedöma; det är ännu inte lokalt verifierat. Även ISO 15189:2022 medger enligt den sekundära återgivningen att tillverkarens referensvärden används, om laboratoriet har verifierat och godtagit deras populationsunderlag [17]. Vi behöver särskilt granska kalibreringen, spårbarheten och om det finns systematiska skillnader vid referensgränserna. Att analyten har samma namn räcker inte för att resultaten ska vara jämförbara [1, §6.2, §10.1].
Analytisk jämförbarhet. Vid metodbyte kan en metodjämförelse enligt CLSI EP09 visa om laboratoriets eget, tidigare etablerade intervall kan behållas. Den kan också visa om intervallet kan räknas om utan nya referensindivider. EP28 anger tre förbehåll: spridningen av värden bland metodjämförelsens prov påverkar korrelationen, interceptet måste bedömas i förhållande till intervallet och linjär regression är inte alltid rätt verktyg. Även efter en omräkning uppmanas laboratoriet att verifiera intervallet med ett fåtal referensindivider [1, §10.1]. ISO 15189:2022 kräver enligt återgivningen att laboratoriet vid analytiska eller preanalytiska metodbyten granskar hur intervallen påverkas [17]; CLSI:s väg via EP09 är ett möjligt sätt att göra den granskningen.
Dokumenterad bedömning. Om originalstudiens population, preanalytik, metod, referensvärden och beräkning är fullständigt beskrivna och stämmer med laboratoriets förhållanden kan intervallet överföras efter en dokumenterad, subjektiv bedömning av underlaget [1, §11.1].
Verifiering med 20 lokala referenspersoner [1, §11.2]. Här prövas om ett redan etablerat intervall kan användas lokalt; inga nya referensgränser beräknas. Originalstudien måste vara korrekt utförd och metod, population och preanalytik jämförbara. Personerna bör i rimlig grad representera laboratoriets friska population och uppfylla exklusions- och partitionskriterierna. Misstänkta utliggare granskas först med Reed/Dixon- eller Tukey-metoden. När 20 godtagbara värden finns räknas hur många som ligger utanför det föreslagna intervallet:
- 0–2 av de första 20 utanför: intervallet kan accepteras enligt denna regel, om övriga förutsättningar är uppfyllda.
- 3–4 av de första 20 utanför: undersök 20 nya referenspersoner enligt samma kriterier och granska även den gruppen för utliggare. Bedöm dess antal värden utanför intervallet för sig. Om högst 2 av dess 20 värden ligger utanför kan intervallet accepteras enligt regeln. Vid 3 eller fler utreds analysförfarandet och möjliga biologiska skillnader mellan populationerna; överväg en egen fullskalig referensstudie.
- 5 eller fler av de första 20 utanför: utred på samma sätt direkt. Någon andra grupp tas inte enligt denna regel.
Gruppernas utfall får inte slås samman till 40 prov när denna regel används; varje grupp bedöms separat. Regeln innehåller ingen tredje grupp. Ett godkänt antal är inte ett bevis för rätt gränser. Regeln kan särskilt missa ett för brett intervall, eftersom få eller inga lokala värden då hamnar utanför. Därför måste jämförbarheten i metod och population bedömas före räkningen [1, §11.2].
Exempel 1 – verifiering (syntetiskt). Metodjämförbarheten för analyt X är dokumenterad. Tjugo lokala personer som uppfyller kriterierna lämnar prov. Ett misstänkt avvikande värde visar sig bero på ett preanalytiskt fel och ersätts med prov från en ny person, så att 20 godtagbara värden återstår. Ett annat högt värde, som inte pekas ut av utliggartestet och saknar påvisad felorsak, behålls och räknas. Tre av de 20 värdena ligger utanför det föreslagna intervallet. Därför undersöks 20 nya personer, utan att resultaten från grupperna läggs ihop. I den nya gruppen ligger 1 av 20 utanför. Intervallet kan då accepteras enligt regeln, förutsatt att de övriga villkoren för överföring är uppfyllda.
Varför en andra grupp ibland behövs. Om 95 % av den lokala referenspopulationens värden ligger inom gränserna väntas i genomsnitt 1 av 20 ligga utanför. Trots det hamnar 3 eller fler av de första 20 utanför i cirka 7,5 % av fallen. Med hela tvåstegsregeln förkastas ett sådant intervall felaktigt i knappt 1 % av fallen [1, §11.2]. Dessa sannolikheter förutsätter oberoende och representativa observationer med 95 % täckning; ett bekvämlighetsurval eller systematiska uteslutningar kan ge annat utfall. Översikten [4] skriver att ett delurval om 40 prov kan användas för verifiering. Den specifika binomialregeln i EP28-A3c börjar däremot med 20 och kräver ytterligare 20 bara vid 3–4 avvikande resultat [1, §11.2].
Utliggare. Vid verifiering bör äkta utliggare som pekats ut med testerna ersättas med nya prov [1, §11.2]. I det allmänna avsnittet betonar CLSI att extremvärden i första hand bör behållas om de inte är kända fel, exempelvis analysfel eller preanalytiska brister [1, §9.2]. I praktiken skulle jag därför utreda ett misstänkt värde innan jag utesluter det. Att värdet ligger utanför det föreslagna intervallet gör det inte i sig till en utliggare.
Vad regeln kan upptäcka. I CLSI:s simuleringar upptäckte binomialregeln lägesförskjutningar förhållandevis väl vid symmetrisk fördelning men sämre vid uttalad skevhet; minskad spridning upptäcktes inte [1, §11.2]. I en senare simulering fann Beck m.fl. att binomialregeln inte kunde förkasta alltför breda intervall. För de simulerade 99,8-procentiga intervallen var den genomsnittliga förkastandefrekvensen 95,8 % med VeRUS och 89,2 % med ekvivalensgränser (EL). VeRUS är en indirekt verifieringsmetod som studiens författare själva utvecklat [13]. Om originalstudiens fullständiga data finns kan de 20 lokala värdena prövas med andra, potentiellt starkare test [1, §11.2]. För särskilt viktiga analyser kan en större lokal grupp, exempelvis 60 personer, jämföras med originaldata [1, §11.3].
Tillverkarintervall i praktiken. I en nederländsk studie jämfördes indirekta och direkta intervall för TSH och fritt T4 på fyra analysplattformar. Flera av tillverkarnas övre gränser avvek från de gränser som studien skattade, medan direkta och indirekta skattningar låg nära varandra efter lämplig åldersindelning [12]. Resultatet gäller de analyser och plattformar som undersöktes. Det ger anledning att granska de lokala metodbladen, men ingen generell faktor att korrigera andra intervall med.
Nordiska intervall. Enligt Equalis [5] kan intervallen från Nordiska referensintervallprojektet (NORIP) [6] användas för utvalda rutinanalyser. Villkoret är att laboratoriets metod visar acceptabel bias mot NFKK Reference Serum X. Intervallen gäller bara de analyser som projektet omfattar. Population och preanalytik behöver fortfarande bedömas [1, §10.2].
Direkt etablering
Arbetsgången enligt EP28-A3c i sammandrag [1, §6–9]:
- Definiera i förväg analyt, provmaterial, metod och avsedd population samt exklusions- och partitionskriterier. Hälsan bör åtminstone bedömas med ett frågeformulär [1, §7.1–7.3]. Välj kriterier som svarar mot frågan: en grupp av enbart unga, mycket friska vuxna är inte självklart rätt för alla patientgrupper [1, §7.4]. Alltför snäva hälsokriterier kan ge ett intervall för en annan population än den som avses; detta är en tolkning av urvalsproblemet som också diskuteras i [4].
- Standardisera preanalytik och analys så att de motsvarar patientprovens. Analysera helst under flera dagar med rutinmässig kvalitetskontroll [1, §8].
- Granska fördelningen visuellt och hantera extremvärden enligt §9.2 (se Utliggare). Riktlinjen stöder statistisk prövning med Dixons kvot (D/R ≥ 1/3) eller Tukeys regel [1, §9.2]. Om värden tas bort rekryteras fler personer tills det finns minst 120 godtagbara värden per partition [1, §9.1].
- Beräkna gränserna. CLSI rekommenderar den enkla icke-parametriska metoden när laboratoriet har begränsad tillgång till statistisk kompetens och beräkningsstöd. Urval, antal och preanalytik väger tyngre än valet av statistisk metod [1, §9].
- Dokumentera kriterier, antal per partition samt analytiska och preanalytiska detaljer [1, §12.2].
A posteriori-urval kan användas för nya eller dåligt kända analyser och kan kräva ett mer omfattande frågeformulär [1, §7.4.1]. För en befintlig kohort rekommenderar jag att man redovisar hur deltagarna valdes ut, hur tillförlitliga hälsouppgifterna är och vilken risk för selektionsbias som finns.
Värden utanför mätområdet. Om många resultat ligger under kvantifieringsgränsen går den nedre percentilen inte att behandla som om alla värden vore exakta tal. Att utan vidare utesluta dem kan snedvrida gränsen. Översikten [4] diskuterar censurerade värden och modellbaserade alternativ. Jag rekommenderar att man redovisar hur dessa resultat har hanterats, hur många de är och vad hanteringen betyder för gränsen. Det är en praktisk slutsats, inte en särskild CLSI-regel.
Antal. Teoretiskt krävs 39 observationer för att skilja 2,5:e från 5:e percentilen; det är ingen rekommenderad studiestorlek. För allmän praxis rekommenderar CLSI minst 120 godtagbara referensvärden per partition; ISO 15189:2022 §7.3.5 anger enligt den sekundära återgivningen inget minsta antal [17]. CLSI:s 120 värden medger icke-parametriska 90-procentiga KI för gränserna. För 95- respektive 99-procentiga KI krävs 146 respektive 210. Behovet beror också på metod, fördelning och önskad precision. Som allmänt kriterium återger CLSI Harris och Boyds rekommendation: bredden av ett 90-procentigt KI för en gräns bör understiga 0,2 gånger referensintervallets bredd [1, §9.1].
Färre än 120. För nyfödda, barn och äldre kan tillräckligt många referenspersoner vara svåra att finna; exempel 2 för vuxna gäller därför inte automatiskt dessa grupper. CLSI anger att värdena även då bör redovisas med icke-parametriska percentiler anpassade till antalet. Den robusta metoden är ett alternativ utan fast minimiantal, men KI kan bli breda [1, §9.1]. Parametrisk skattning och bootstrap är andra alternativ när kompetens finns [1, §9]. Med bootstrap drar man upprepade stickprov med återläggning ur de värden som redan finns. Metoden beskriver stickprovsosäkerhet, men tillför inga nya individer och rättar inte till ett snedvridet urval. Förklaringen av bootstrap är min egen; den är inte hämtad från CLSI.
Översikten [4] förordar parametrisk skattning vid gaussisk fördelning och minst 120 värden; det är ingen CLSI-regel.
Partitionering. Frågan är om separata intervall är fysiologiskt motiverade och gör klinisk nytta. En statistiskt signifikant skillnad i medelvärde räcker inte, eftersom även betydelselösa skillnader blir signifikanta med stort n. Harris och Boyds kriterier förutsätter gaussisk fördelning och speglar inte fördelningarnas svansar. Ett alternativ är att bedöma hur stor andel av varje undergrupp som hamnar utanför de gemensamma gränserna [1, §9.3]. Lahti m.fl. har beskrivit partitionering av icke-gaussiskt fördelade data [7].
Exempel 2 – icke-parametrisk skattning (syntetiskt).
- 120 kvalificerade vuxna ger ett värde var. Inga värden har tagits bort efter utredningen.
- Värdena rangordnas: x(1) ≤ … ≤ x(120).
- Nedre gränsens rang blir 0,025 × 121 = 3,025 och övre gränsens 0,975 × 121 = 117,975. I detta specialfall avrundar EP28-A3c till x(3) och x(118). Anta att dessa ordnade värden är 74 respektive 132 godtyckliga enheter. Det skattade intervallet blir då 74–132. I allmänhet interpoleras värdet [1, §9.4.1].
- Enligt riktlinjens tabell spänner 90-procentigt KI för nedre gränsen över x(1)–x(7). Anta att de värdena är 70 och 79. För övre gränsen spänner KI över x(114)–x(120), här antaget 128–139, eftersom tabellrangerna dras från n + 1 [1, §9.5.1]. Resultatet skrivs alltså nedre gräns 74 (90 % KI 70–79); övre gräns 132 (90 % KI 128–139). Det är två KI kring två gränser, inte ett KI kring en enskild persons värde.
- Om materialet delas i två partitioner om 60 hamnar gränserna nära de yttersta observationerna. Tabellens KI börjar vid n = 119 och kan då inte användas [1, §9.5.1]. Varje partition behöver eget material [1, §9.1].
Indirekt skattning
Indirekt skattning använder resultat från databaser som upprättats för andra ändamål, oftast rutinvård. Ur dessa data försöker man med statistiska metoder urskilja en antagen icke-patologisk fördelning [1, §7.4.2; 3]. CLSI och IFCC-gruppen gör olika bedömningar av indirekta metoder, medan ISO-punkten enligt PJLA:s återgivning inte väljer metod:
- CLSI EP28-A3c (2010) stöder inte indirekta tekniker som primär metod. Riktlinjen kallar resultaten i bästa fall grova skattningar, eftersom antagandet att merparten av data kommer från referensindivider kan vara fel. Den rekommenderar direkt metod när det är möjligt [1, §7.4, §7.4.2].
- IFCC C-RIDL:s Opinion Paper (2019) uppmuntrar till indirekta metoder för att etablera och verifiera intervall, och till publicering med tydlig processbeskrivning. Kommittén anger att även indirekt härledda intervall ska verifieras före kliniskt bruk [3].
- ISO 15189:2022 §7.3.5 föreskriver enligt den sekundära återgivningen varken direkt eller indirekt metod. Kraven gäller att intervallen speglar patientpopulationen och att underlaget dokumenteras och granskas [17].
Problemet med blandade patientdata. Rutindata omfattar även resultat från sjuka personer. Effekten på gränserna beror på andelen sjukdomspåverkade resultat och på hur mycket deras värdefördelning överlappar referenspopulationens [3]. RIbench jämförde Hoffmann, TML, TMC, kosmic och refineR, som alla förutsätter att de flesta resultaten är icke-patologiska. TML, TMC, kosmic och refineR beskriver referensdelen med en Box–Cox-transformerad normalfördelning (även kallad potensnormalfördelning). Hoffmann förutsätter normalitet på den skala som analyseras; i RIbench prövades metoden efter transformation med den sanna parametern λ [8].
Ett icke-patologiskt resultat betyder här att värdet för just denna analyt antas vara opåverkat av sjukdom. Det säger inte att personen är frisk. Även en sjuk patient kan bidra med ett sådant värde, och den skattade andelen i den icke-patologiska komponenten kan därför inte läsas som sjukdomsprevalens.
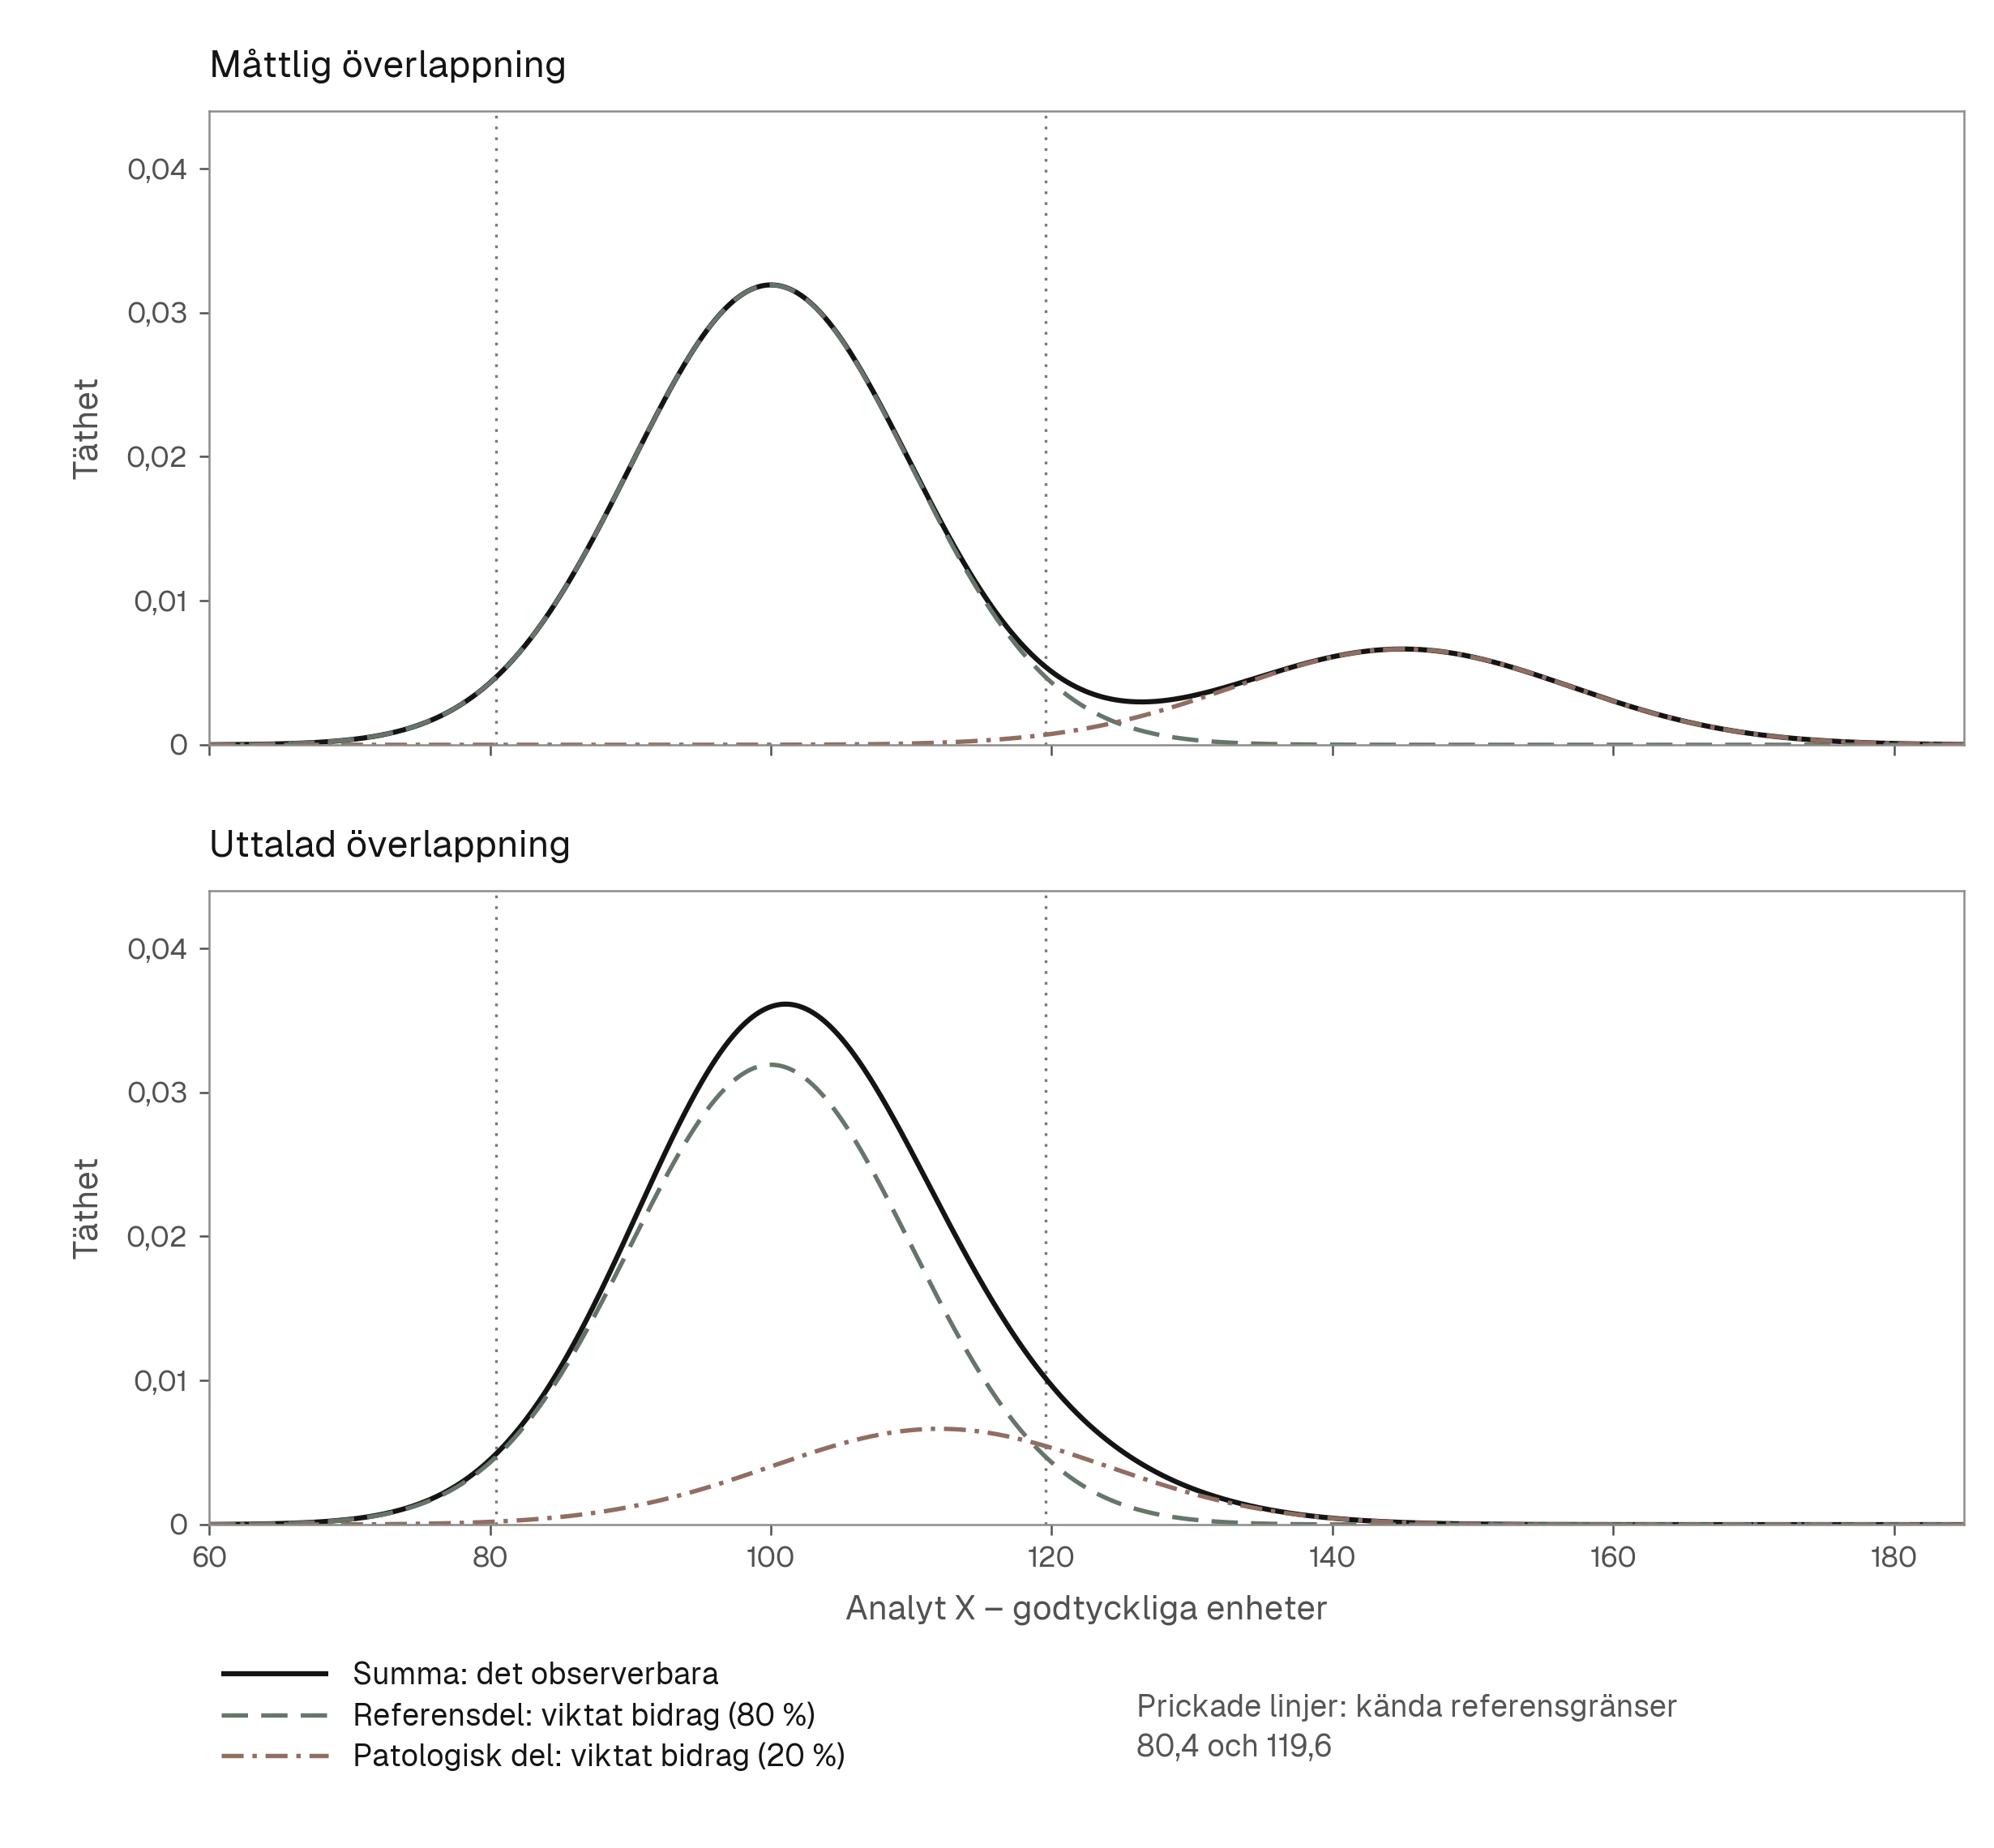
Figur 1. Syntetisk undervisningsmodell, inte patientdata och inte resultatet av någon namngiven metod. Referenskomponenten utgör 80 % och den patologiska komponenten 20 % i båda diagrammen. Komponentkurvorna är viktade bidrag, inte normerade fördelningar, och den svarta kurvan är deras summa. Rutindata ger observationer från blandningen, inte separata komponentfördelningar. Referenskomponentens 2,5:e och 97,5:e percentil är kända bara därför att modellen är konstruerad. Vid större överlappning blir det i detta exempel svårare att urskilja referenskomponentens form och spridning ur summakurvan. Ett enskilt mätvärde i överlappsområdet kan inte med säkerhet hänföras till någon av komponenterna.
En kurva kan passa de observerade värdena väl och ändå ge fel referensgränser. I en blandad databas är individernas referensstatus i regel okänd, så vi kan inte kontrollera den antagna icke-patologiska fördelningen direkt. Det här är min statistiska slutsats om vad som går att identifiera i data; den kommer inte från CLSI. Begränsningen blir särskilt viktig när sjukdomspåverkade värden överlappar de icke-patologiska [3, 8].
Databeredning enligt IFCC-gruppen [3]:
- Källa: för hälsorelaterade intervall föredras data från öppenvård, särskilt primärvård.
- Ett värde per person: sjuka provtas oftare om. IFCC föreslår att den sista mätningen under en vårdepisod väljs, eftersom den kan ligga närmare ett tillfrisknande [3]. Om en person har flera episoder behövs också en förutbestämd regel för vilken episod som används, så att personen fortfarande bidrar med bara ett resultat. Det senare är en praktisk precisering. Ett alternativ enligt IFCC är att bara ta med personer med ett enda prov [3].
- Stabil analys: granska metodbyten, populationsförändringar, medianer och percentiler över tid samt kvalitetskontrolldata. Begränsa data till en stabil period. Minst ett års data kan avslöja årstidsvariation.
- Partitioner: plotta medianer och percentiler mot ålder, uppdelat på kön.
- Filtrering och transformation: biokemisk filtrering kan minska sjukdomsandelen. En överlappande sjuk delpopulation kan få fördelningen att se skev ut, och en transformation kan då föra in sjukdomsvärden i intervallet.
- Avstå när data domineras av patologiska resultat, till exempel för analyser som sällan beställs utan stark misstanke om sjukdom.
Från filtrering till färdiga gränser. Förfiltrering, till exempel biokemisk filtrering med stöd av andra analysresultat, görs före den statistiska skattningen [3]. Utjämning av gränser över ålder görs efteråt. Båda stegen är skilda från själva fördelningsanpassningen, även när samma programvara sköter dem. Jag föreslår därför att varje steg beskrivs separat i redovisningen.
Anpassningsområde och referensgränser. Flera av metoderna nedan börjar med att välja ett område på mätskalan där referensvärdena antas dominera. Där anpassas en parametrisk fördelning. Referensgränserna beräknas sedan som 2,5:e och 97,5:e percentilen i hela den modellerade fördelningen. Om gränserna hamnar utanför anpassningsområdet bygger de på extrapolering av modellen. Anpassningsområdet är alltså den del av data som används för att skatta fördelningen. Det är inte samma sak som det färdiga referensintervallet.
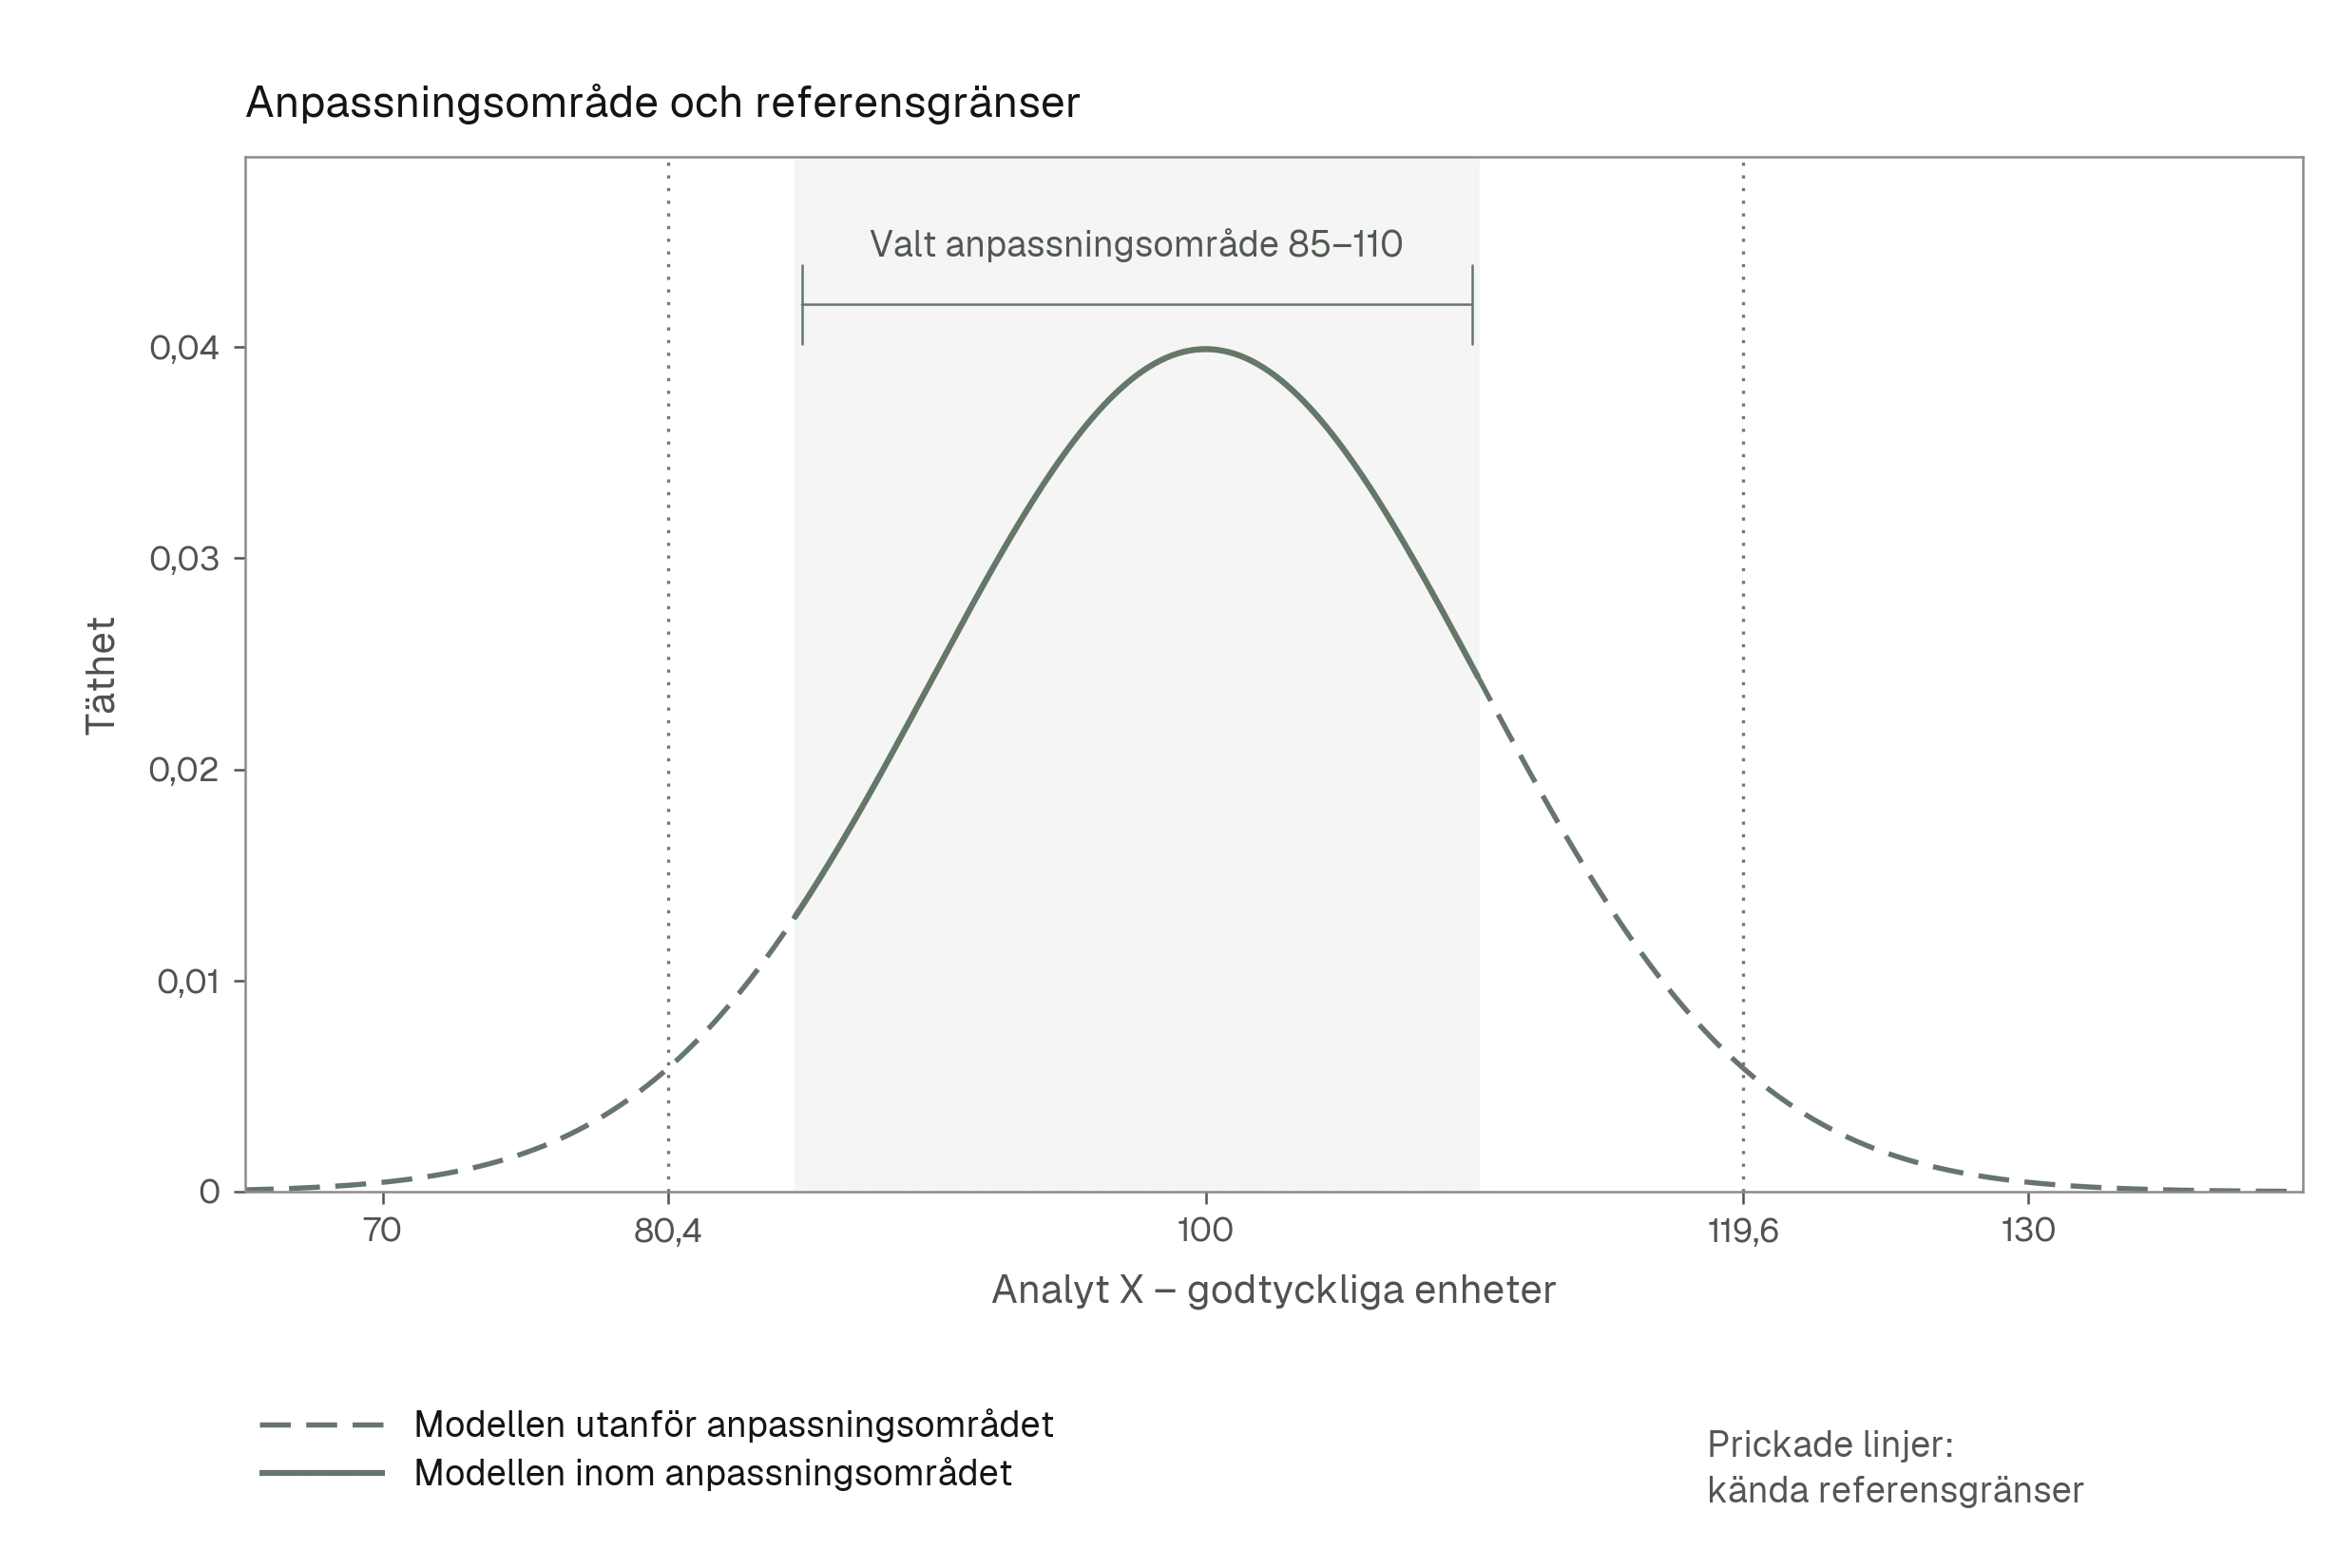
Figur 2. Syntetisk undervisningsmodell. Kurvan är en konstruerad normalfördelning (medelvärde 100, standardavvikelse 10), och anpassningsområdet 85–110 är godtyckligt valt. Varken området eller kurvan har tagits fram med TML, kosmic, refineR eller någon annan algoritm. Den streckade delen visar hur den antagna referenskomponenten fortsätter utanför anpassningsområdet. Gränserna 80,4 och 119,6, det vill säga 100 ± 1,96 × 10, ligger båda utanför området och följer av modellen.
Hur trunkerade data används i modellen – egen statistisk förklaring. Att stryka värdena utanför anpassningsområdet och beräkna percentiler på dem som återstår ger percentiler i ett avkortat stickprov. Med området i figur 2 kan sådana percentiler aldrig hamna utanför 85–110, och intervallet blir för smalt. En trunkerad likelihood är i stället villkorad på att bara värden inom området observeras: modellens sannolikheter räknas om så att de summerar till 1 inom området. Parametrarna beskriver då hela komponenten, även dess del utanför området.
Transformationen är en hypotes. Box–Cox-transformationen är en potensbaserad transformation med parametern λ; gränsfallet λ = 0 motsvarar logaritmering. Flera av metoderna antar att referenskomponenten blir normalfördelad efter en sådan transformation [8]. Att formen blir sådan är ett antagande i modellen. Det är inte något som data i sig visar. En skev summakurva kan bero på en överlappande sjuk delpopulation snarare än på en skev referensfördelning, och en transformation kan då föra in sjukdomsvärden i intervallet [3]. Har referensfördelningen en annan form kan gränserna bli fel, även om anpassningen ser god ut.
När inget referensdominerat område finns. Metoder med anpassningsområde förutsätter ett område där referensvärdena dominerar. Det kan saknas när patologiska resultat är i majoritet, när den till synes dominerande centrala toppen själv består av sjukdomspåverkade värden, eller när referensdelen är avkortad av mätområdet, flertoppig eller av andra skäl svår att identifiera. Även i en sådan situation kan algoritmen lämna ifrån sig siffror som vid en första blick ser rimliga ut. Punkt 6 i databeredningen gäller just sådana data [3], och i RIbench ökade samtliga metoders avvikelse från de sanna gränserna vid hög patologisk andel, exempelvis 50 % [8].
Metoderna. Tabellen tar upp ett urval av namngivna metoder. Även de klassiska Hoffmann- och Bhattacharya-metoderna finns i datoriserade versioner [3]. Beskrivningarna av dem bygger här på Holmes och Buhr [18] och IFCC-gruppens rekommendationer [3]. Programvarorna ändras över tid. Beskrivningarna av metoderna i tabellen och texten nedan avser de versioner som anges i källorna.
| Metod | Antagen form på referensdelen | Vad som anpassas och hur | Hur gränserna fås |
|---|---|---|---|
| Hoffmann [18] | Normalfördelning | Rät linje genom ett valt segment av den kumulativa fördelningen på normalfördelningens sannolikhetsskala | Linjen avläses vid 2,5 och 97,5 % (z = ±1,96) |
| Bhattacharya [3, 18] | Normalfördelning | Rät linje genom ett valt segment av differenserna mellan logaritmerade frekvenser i angränsande histogramklasser | Linjens parametrar används för att skatta spridning och medelvärde |
| TML [3, 8] | Box–Cox-transformerad normalfördelning | Maximum likelihood, villkorad på ett trunkeringsintervall | Percentiler i hela modellen, återtransformerade |
| TMC [9, 10] | Potensnormalfördelning | Startvärden ur ett QQ-diagram; minsta chi-kvadrat för klassfrekvenser inom trunkeringsintervallet | Percentiler i den anpassade fördelningen |
| kosmic [19] | Box–Cox-transformerad normalfördelning | Minsta Kolmogorov–Smirnov-avstånd; trunkeringspunkter och parametrar optimeras | Percentiler i modellen, återtransformerade |
| refineR [9] | Box–Cox-transformerad normalfördelning | Förväntade klassfrekvenser jämförs med observerade med en Poissonbaserad kostnad; rutnätssökning | Percentiler i den anpassade icke-patologiska fördelningen |
| reflimR, version 1.0.6 [20] | Normal- eller lognormalfördelning | Iterativ trunkering med modifierat lådagram; linje i QQ-diagram över de trunkerade värdena | Extrapolerade gränser, jämförda med de gränser som ska verifieras |
| Ändliga blandningsmodeller [18] | Flera normal- eller lognormalkomponenter | Maximum likelihood över alla data, till exempel med EM-algoritmen | Percentiler i den komponent som bedöms vara referensdelen |
Hoffmann. Enligt Holmes och Buhr [18] delas alla resultat in i klasser, och mätvärdena plottas mot kumulativ procent på normalfördelningens sannolikhetspapper, det vill säga mot z = Φ⁻¹(F(x)), där F(x) är den observerade kumulativa andelen och Φ⁻¹ normalfördelningens kvantilfunktion. Den moderna motsvarigheten är ett kvantil–kvantil-diagram (QQ-diagram) mot normalfördelningen. Skalornas skillnad visas i figur 3. En rät linje genom det segment som antas domineras av referensvärden förlängs till z = ±1,96. En utbredd variant plottar i stället mot kumulativ procent på linjär skala; i Holmes och Buhrs teoretiska analys, simuleringar och data gav den för smala intervall [18]. Det betyder inte att varje metod som kallas modifierad Hoffmann är felaktig; varianten måste bedömas för sig.
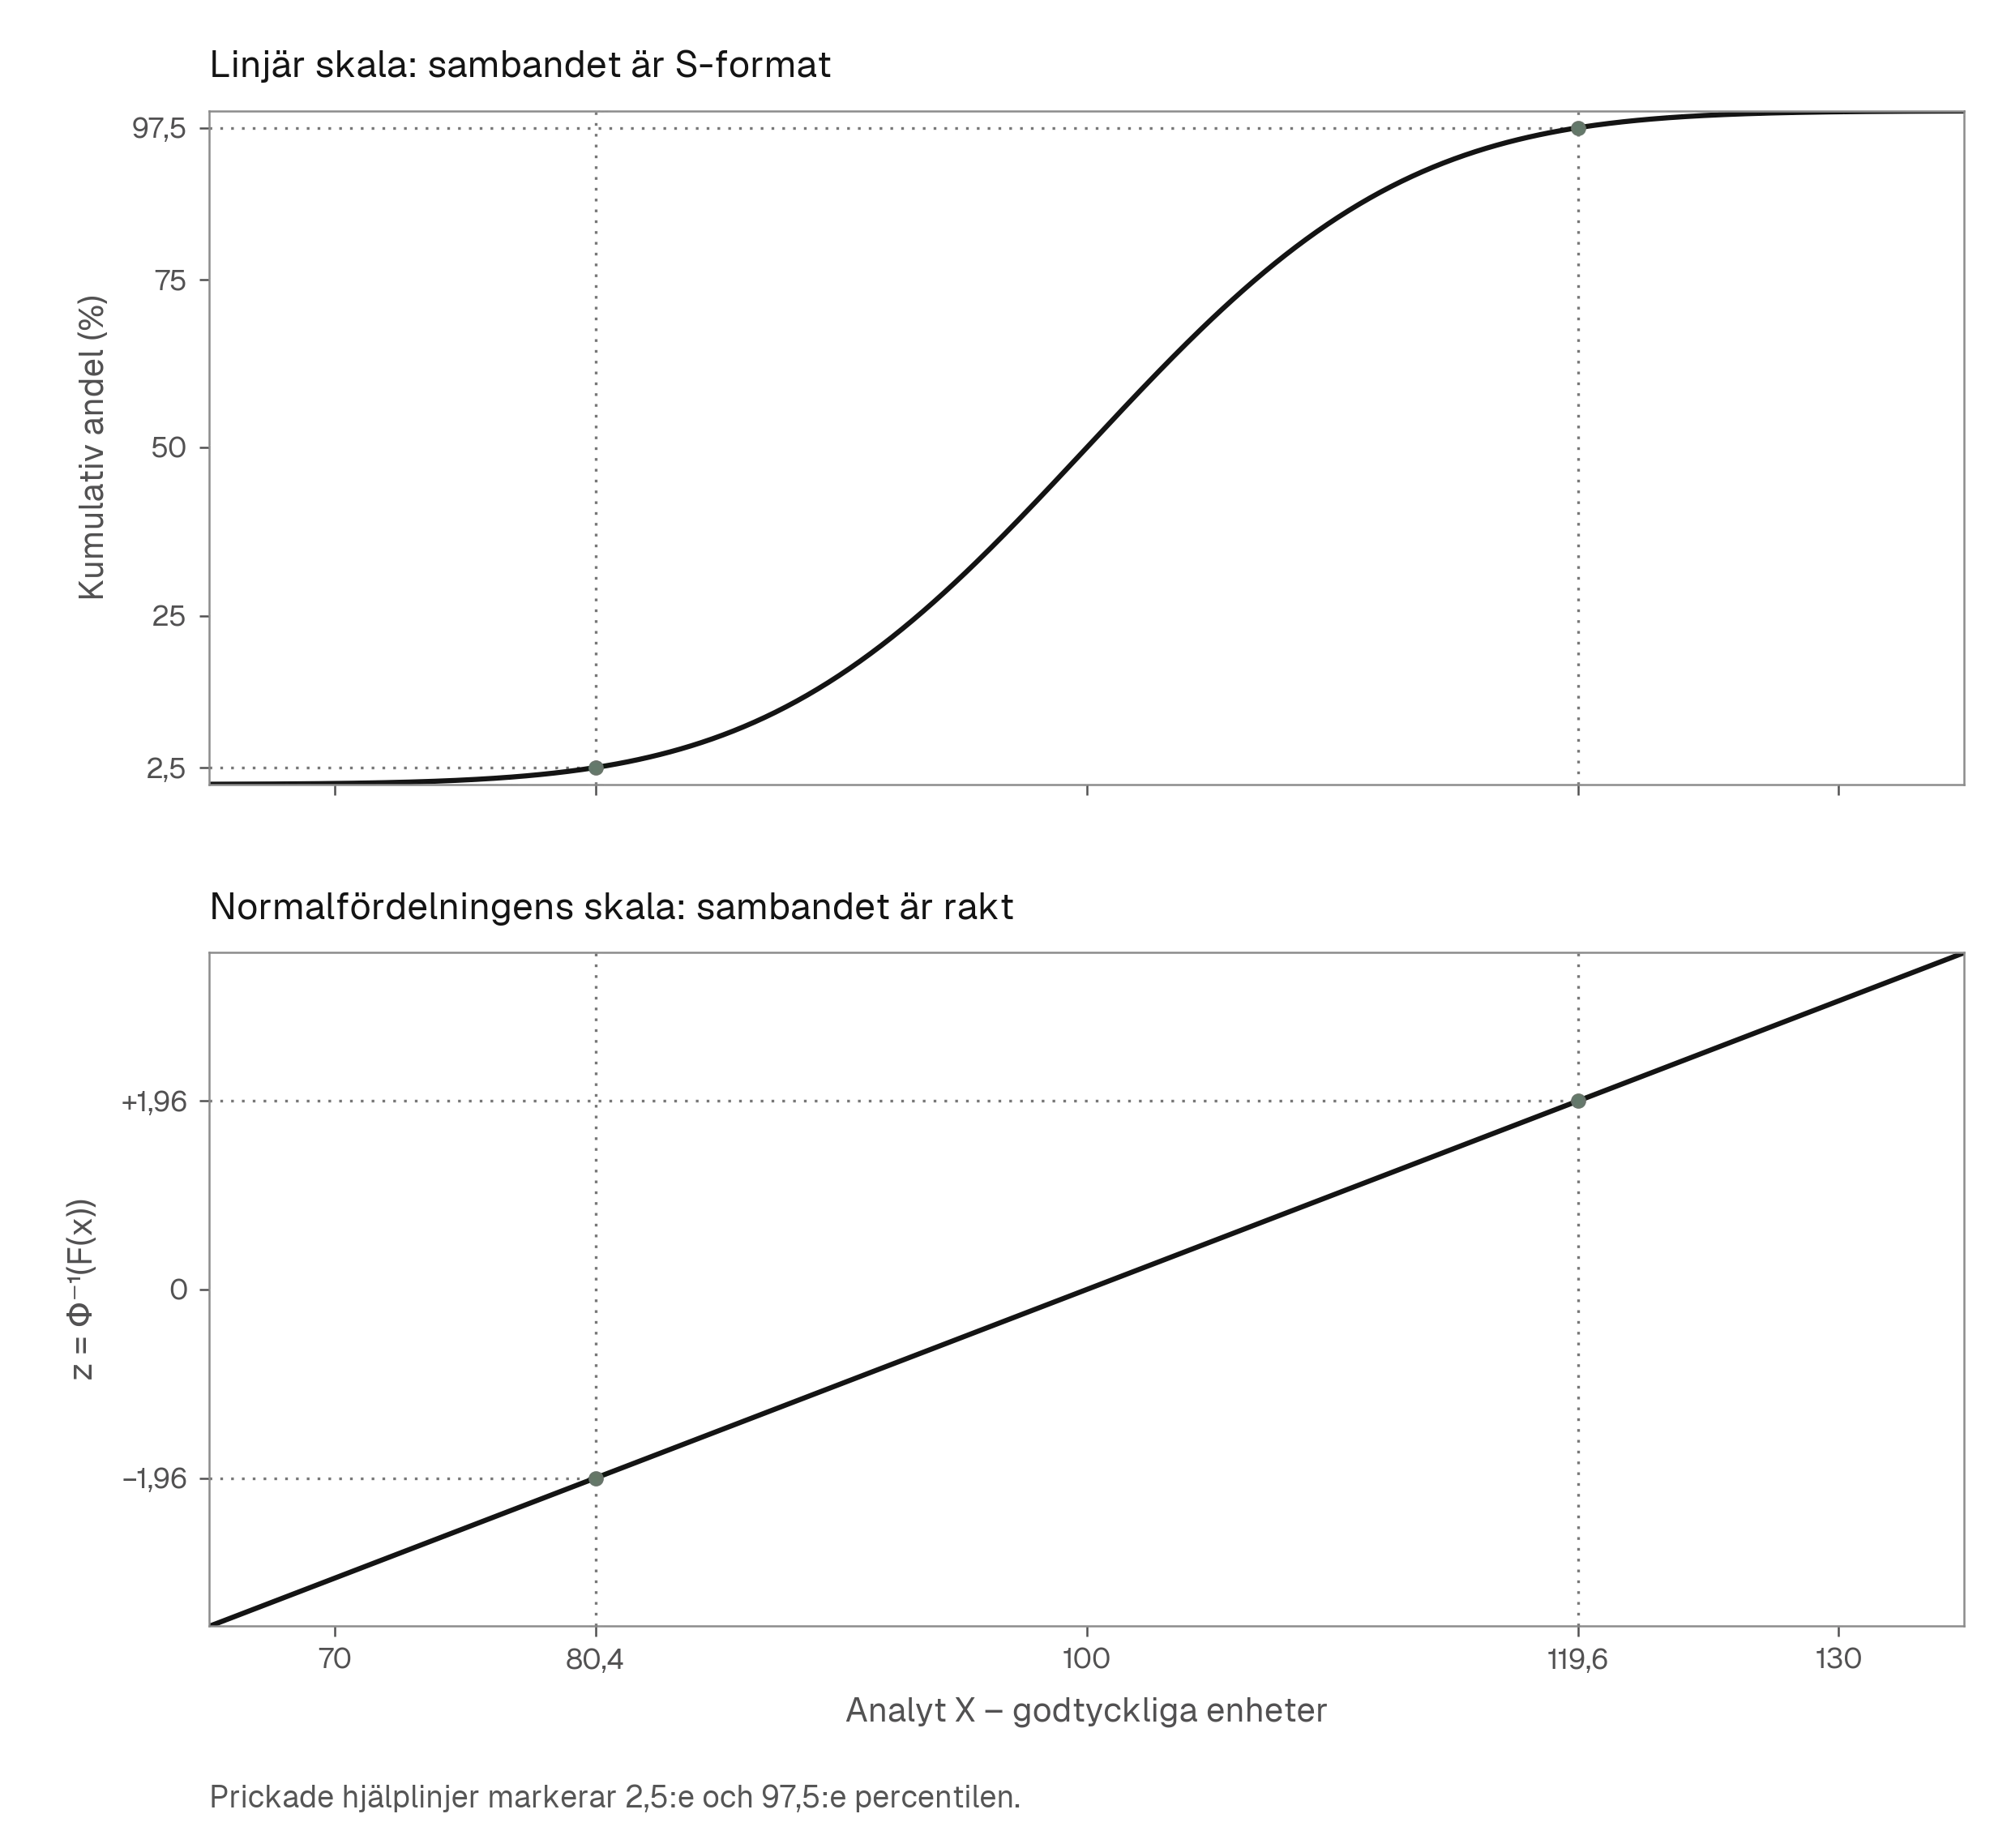
Figur 3. Idealiserad normalfördelning (medelvärde 100, standardavvikelse 10) utan patologiska resultat. På linjär skala för kumulativ andel är sambandet S-format; mot normalfördelningens sannolikhetsskala, z = Φ⁻¹(F(x)), blir det en rät linje, och z = ±1,96 motsvarar 2,5:e och 97,5:e percentilen (80,4 och 119,6). Den felaktiga variant som Holmes och Buhr beskriver använder den linjära skalan [18]. Figuren visar bara skalans logik. Den visar inte att en linje genom blandade patientdata återger referenskomponentens parametrar.
Bhattacharya. Enligt Holmes och Buhrs redogörelse [18] plottas differensen mellan logaritmerade frekvenser i angränsande, lika breda histogramklasser mot klassmitten. En normalfördelad komponent ger då ett ungefär linjärt segment, och dess parametrar används för att skatta spridning och medelvärde, med hänsyn till klassbredden. Komponenten måste dominera det valda segmentet. Resultatet är känsligt för klassbredd och det subjektiva valet av segment. IFCC-gruppen beskriver metoden som bättre än Hoffmann på att separera överlappande fördelningar [3]. Det innebär inte att godtyckligt överlappande komponenter alltid kan skiljas åt. Detta sista förbehåll är min statistiska precisering.
TML (trunkerad maximum likelihood). En Box–Cox-transformerad normalfördelning anpassas med maximum likelihood till värdena inom ett centralt trunkeringsintervall, villkorat på trunkeringen. De skattade parametrarna (λ, medelvärde, spridning) beskriver hela komponenten, och gränserna är dess 2,5:e och 97,5:e percentil efter återtransformation [3, 8]. Programvaran har ändrats över tid, och kosmic-författarna skrev 2020 att en samlad, fullständig beskrivning av den då distribuerade algoritmen saknades [19]. När vi jämför studier behöver vi därför kontrollera vilken beräkning som faktiskt har använts, även om alla kallar metoden TML.
TMC (trunkerad minsta chi-kvadrat). Startvärden för en antagen potensnormalfördelning, alltså en normalfördelning efter potenstransformation, skattas ur ett QQ-diagram. De förfinas iterativt genom att antalet värden i klasser inom trunkeringsintervallet anpassas med minsta chi-kvadrat. Ett straffled motverkar att modellen förutsäger väsentligt fler värden utanför intervallet än som observerats [10]. Metoden har utvecklats för bland annat skeva data [10]. Även TMC förutsätter att referensvärdena dominerar inom trunkeringsintervallet.
kosmic. Zierk m.fl. söker de trunkeringspunkter och modellparametrar som minimerar Kolmogorov–Smirnov-avståndet mellan en hypotetisk normalfördelning och de Box–Cox-transformerade observerade värdena [19]. KS-avståndet är den största skillnaden mellan två kumulativa fördelningar, alltså ett annat mått än chi-kvadrat för klassfrekvenser eller likelihood. Gränserna är modellens percentiler efter återtransformation. Metoden kräver en tillräckligt identifierbar referensdominerad del och att potensnormalfördelningen passar. Optimeringen garanterar inte att den anpassade delen saknar avvikande värden, och kosmic ska inte likställas med en oförändrad TML [19].
refineR. Ammer m.fl. antar att den dominerande icke-patologiska komponenten kan beskrivas med en Box–Cox-transformerad normalfördelning och att det finns ett område med försumbart patologiskt bidrag [9]. Metoden arbetar inverst: för kandidatvärden på λ, medelvärde, spridning och den icke-patologiska komponentens andel P förutsägs förväntade antal i histogramklasser på den ursprungliga mätskalan. Asymmetriska konfidensband avgör vilka klasser som bidrar till en Poissonbaserad kostnad (negativ log-likelihood), och parametrarna optimeras med rutnätssökning i flera nivåer. Gränserna är percentiler i den anpassade icke-patologiska fördelningen. refineR är alltså inte fördelningsfri och klassar inga patienter. Bootstrapbaserade KI beskriver stickprovsosäkerhet men korrigerar inte ett felaktigt modellantagande; författarna påpekar själva att Box–Cox-antagandet inte passar alla fördelningar [9].
reflimR. Hoffmann m.fl. beskriver version 1.0.6 år 2024 [20]. Normal- eller lognormalfördelning väljs med Bowleys kvartilbaserade skevhetsmått. Data trunkeras sedan iterativt med ett modifierat lådagram, och referensgränserna extrapoleras från ett QQ-diagram över de trunkerade värdena. Trunkeringen syftar här till att behålla de centrala 95 % av de förmodat icke-patologiska värdena. De slutliga gränserna beräknas därefter i ett separat QQ-steg och kan ligga nära trunkeringsgränserna. De skattade gränserna jämförs med de gränser som ska verifieras, med toleransmarginaler. Studien av Meyer m.fl. [11] gäller RefLim. Den verifierar därför inte automatiskt egenskaperna hos den senare reflimR-version som beskrivs i [20].
Ändliga blandningsmodeller. Här handlar det om en familj av modeller, inte om en standardiserad metod för referensintervall. Hela datamängden beskrivs som en summa av flera normal- eller lognormalkomponenter med var sin vikt, medelvärde och spridning. Parametrarna skattas med maximum likelihood, till exempel med EM-algoritmen. Holmes och Buhr prövade sådana modeller som alternativ till Hoffmann-metoden [18]. Att modellen passar bra visar att summan av komponenterna beskriver data väl. Vi vet därmed fortfarande inte vilken av komponenterna som motsvarar referensvärdena. Valet av referenskomponent måste motiveras separat; gränserna är percentiler i just den komponenten.
Vad metoderna inte gör. Ingen av metoderna avgör om en enskild patient är frisk eller sjuk. De skattar en komponent i en blandning. Verifieringsverktyg som VeRUS [13] jämför ett föreslaget intervall med ett intervall som skattats indirekt ur lokala rutindata, för att bedöma det föreslagna intervallet. Vilken metod som passar den aktuella analyten går inte att avgöra utifrån metodnamnet.
RIbench är en simuleringsstudie [8]. Den omfattade tio simulerade analyter med fyra fördelningstyper, n från 1 000 till 500 000, en patologisk andel på 0–60 % och varierande överlappning. Fem indirekta metoder jämfördes med en direkt icke-parametrisk metod med n = 120. Huvudfynden:
- Den patologiska andelen påverkade resultaten mer än n. Även överlappningen mellan patologisk och icke-patologisk fördelning hade betydelse.
- Vid högst 20 % patologisk andel och minst 5 000 observationer var de flesta metoderna jämförbara med eller bättre än direkt metod med n = 120. Jämförelsen gällde avvikelsen från de sanna simulerade gränserna; även direktmetoden hade stickprovsfel. Författarna anger ingen generell stickprovsstorlek [8]. Min tolkning är att kombinationen inte kan användas som praktisk tröskel, eftersom andelen patologiska resultat vanligen är okänd i verkliga rutindata. Den säger inte heller hur nära gränserna hamnar i en verklig patientpopulation.
- Mer data räckte inte alltid. För en skev och förskjuten, LDH-liknande fördelning hade alla metoder systematisk bias oavsett datamängd. Undantaget var refineR med tillvalet tvåparametrisk Box–Cox-transformation.
- I RIbench:s implementation var Hoffmann-metoden jämförbar bara upp till cirka 5 % patologisk andel, trots att den fick den sanna transformationsparametern. Den blev inte heller bättre med större n. Det fanns ingen automatiserad referensversion av metoden, och författarna tillämpade ingen avancerad optimering av sin implementation.
- Vid hög patologisk andel, exempelvis 50 %, ökade avvikelsen från de sanna gränserna för samtliga metoder.
Författarna påpekar att simuleringarna bygger på nästan optimala indata. Den förfiltrering som ofta behövs för rutindata prövades inte i studien. Den direkta metodens osäkerhet kan vara underskattad, eftersom bara stickprovsfel modellerades. Författarna står bakom refineR, och flera av dem även bakom kosmic. Tre författare var anställda hos Roche, varav en hade aktier i F. Hoffmann-La Roche Ltd; studien finansierades av Roche Diagnostics [8].
Studier med verkliga laboratoriedata. Meyer m.fl. jämförde RefLim (föregångaren till reflimR), TML och refineR för fyra enzymer vid åtta europeiska laboratorier. Metoderna gav ibland missvisande eller svårtolkade gränser, särskilt när modellens antaganden passade data dåligt. Författarna föreslog att flera metoder kan ge en mer tillförlitlig bedömning tillsammans, men de kunde inte fastställa sanna referenspercentiler i de blandade patientdata [11]. Den nederländska TSH/fritt T4-studien fann god överensstämmelse mellan direkt och indirekt skattning på de undersökta plattformarna när ålder hanterades lämpligt [12]. Båda studierna gäller specifika analyter. Den ena har industriknutna författare; i den andra ingår författare som också medverkar i översikten [4]. Studierna ger stöd för att metoderna kan vara användbara, men visar inte att en algoritm alltid ger rätt gränser.
Osäkerhet. Jag tolkar ett modellbaserat KI som giltigt bara under förutsättning att modellen, urvalet och den analytiska stabiliteten är riktiga. Om något av dessa antaganden brister syns det inte i KI. Den tolkningen stöds av att RIbench fann systematisk bias trots stora datamängder [8] och av KI:s förutsättningar enligt EP28-A3c [1, §9.5]. RIbench-författarna rekommenderar att experter i laboratoriemedicin granskar resultaten kritiskt [8].
Verifiering före bruk. IFCC-gruppen beskriver två vägar [3]. Den ena är 20 referensindivider enligt EP28-A3c. Den andra är att jämföra andelen flaggade resultat i den egna patientpopulationen med den förväntade andelen från den indirekta studien, med tolerans bestämd i förväg. Ingen av kontrollerna löser ensam problemet med ett alltför brett indirekt intervall: 20-personersregeln kan acceptera det [1, §11.2], medan flaggningsandelen också beror på patientmixen. Även indirekta verifieringsverktyg som reflimR [20] och VeRUS [13] vilar på egna modellantaganden. Det är den slutsats jag drar när jag väger samman dessa begränsningar hos metoderna. När gränserna är kliniskt viktiga bör laboratoriet dessutom granska metodens anpassning, alternativa urval och gränsernas rimlighet i relation till annan relevant evidens [3, 11].
Exempel 3 – indirekt skattning (syntetiskt).
- 12 000 öppenvårdsresultat för analyt X, med uppgift om vårdepisod, hämtas från två år.
- Månadsmedianerna visar ett språng vid ett kalibratorbyte. Med stöd av kvalitetskontrolldata används bara den stabila perioden efter bytet; 9 000 resultat återstår.
- En vårdepisod per person väljs enligt en på förhand bestämd regel. Från den episoden behålls sista resultatet; även personer med flera episoder bidrar alltså med ett enda värde. Detta konkretiserar IFCC:s förslag [3]. Åtta tusen resultat återstår.
- Percentiler plottas mot ålder, uppdelat på kön, innan partitionerna bestäms.
- En dokumenterad indirekt metod ger här, enbart i detta påhittade exempel, gränserna 76–134 godtyckliga enheter. Anpassning och KI redovisas [3]. Anpassningsområde och transformation anges separat, så att de inte förväxlas med intervallet. En annan metod ger 78–140. Skillnaden vid övre gränsen är en varningssignal att undersöka; den får inte döljas genom att välja det resultat som verkar mest bekvämt. Metodjämförelsen är ett pedagogiskt förslag, inte ett krav i [3].
- IFCC beskriver också urval av personer med endast ett prov [3]. När gränserna skattas om med det urvalet blir de i exemplet 77–137. Skillnaden illustrerar att hanteringen av upprepade prov kan påverka gränserna; siffrorna är påhittade och visar ingen generell effektstorlek.
- Modellens antaganden, alternativa urval och eventuella metodskillnader granskas. Praktiskt förslag: om skillnaderna inte kan förklaras tillräckligt väl tas inget av intervallen i bruk. Annars dokumenteras varför ett av förslagen har valts, och just det förslaget prövas för kliniskt bruk enligt [3]. Det går inte att välja rätt intervall enbart från de påhittade siffrorna här.
Från skattning till laboratoriesvar
Enligt CLSI bör intervallets ursprung och underlag dokumenteras: antal och demografi, hälsokriterier, exklusioner, partitioner, gruppstorlekar samt analytiska och preanalytiska förhållanden. Även verifieringsdata bör sparas. Laboratoriesvaret bör visa rätt intervall för patientens grupp och använda ”referensintervall”, inte ”normalt”. Ändringar bör meddelas användarna och anges på svaret [1, §12.2]. ISO 15189:2022 kräver enligt den sekundära återgivningen att underlaget dokumenteras, att intervallen granskas periodiskt och vid metodbyten och att ändringar kommuniceras [17]. För publicering av indirekta studier listar IFCC-gruppen också datakälla, filtrering, analyskvalitet, statistisk metod, osäkerhet och modellanpassning [3].
Kontroll i laboratoriedatasystemet. Som lokal kvalitetsåtgärd föreslår jag att visning och flaggning testas innan ett nytt intervall tas i bruk. Använd testpatienter på båda sidor om ålders- och könsgränserna och mätvärden vid referensgränserna. Dokumentera också hur ofta intervallen ska granskas och vad som ska utlösa en extra granskning, till exempel metodbyte eller ändrad patientmix.
Sammanfattning
Ett befintligt intervall behöver prövas mot de lokala förhållandena innan det överförs [1, §10–11]. Behöver laboratoriet ta fram nya gränser kan det göra det direkt från definierade referensindivider [1, §6–9] eller genom att indirekt försöka urskilja en referensfördelning ur blandade data [3]. Oavsett väg behöver valet, antagandena och verifieringen dokumenteras innan gränserna används i laboratoriesvar [1, §12.2; 3]. Enligt den sekundära återgivningen av ISO 15189:2022 ansvarar laboratoriet för att intervallen speglar patientpopulationen och granskas [17]. CLSI, IFCC och forskningen ger underlag för hur det kan göras. Att CLSI, IFCC eller en studie anger ett visst tal innebär alltså inte att talet också är ett ISO-krav.
Referenser
- Clinical and Laboratory Standards Institute. Defining, establishing, and verifying reference intervals in the clinical laboratory; approved guideline – third edition. CLSI document EP28-A3c. Wayne (PA): CLSI; 2008 (korrigerad version oktober 2010; bekräftad på nytt april 2020) [produktsida, citerad 2026-09-30]. Tillgänglig från: https://clsi.org/shop/standards/ep28/
- Clinical and Laboratory Standards Institute. EP28IG: implementeringsguide till EP28. 1:a uppl. Wayne (PA): CLSI; 2022 [produktsida, citerad 2026-09-30]. Tillgänglig från: https://clsi.org/shop/standards/ep28ig/
- Jones GRD, Haeckel R, Loh TP, Sikaris K, Streichert T, Katayev A, et al. Indirect methods for reference interval determination – review and recommendations. Clin Chem Lab Med. 2019;57(1):20–29. doi:10.1515/cclm-2018-0073
- Olthof A, de Kroon RWPM, Dirks NF, Boelen A, Brouwer N, den Heijer M, et al. How to establish a reference interval: a practical approach. Clin Chem. 2026. Epub före tryck. doi:10.1093/clinchem/hvag128
- Equalis. Nordiska referensintervall [Internet]. Equalis AB [citerad 2026-09-30]. Tillgänglig från: https://www.equalis.se/sv/produkter-tjanster/kunskapsstod/projekt-for-nationell-harmonisering/nordiska-referensintervall/
- Rustad P, Felding P, Franzson L, Kairisto V, Lahti A, Mårtensson A, et al. The Nordic Reference Interval Project 2000: recommended reference intervals for 25 common biochemical properties. Scand J Clin Lab Invest. 2004;64(4):271–284. doi:10.1080/00365510410006324
- Lahti A, Hyltoft Petersen P, Boyd JC, Rustad P, Laake P, Solberg HE. Partitioning of nonGaussian-distributed biochemical reference data into subgroups. Clin Chem. 2004;50(5):891–900. doi:10.1373/clinchem.2003.027953
- Ammer T, Schützenmeister A, Prokosch HU, Zierk J, Rank CM, Rauh M. RIbench: a proposed benchmark for the standardized evaluation of indirect methods for reference interval estimation. Clin Chem. 2022;68(11):1410–1424. doi:10.1093/clinchem/hvac142
- Ammer T, Schützenmeister A, Prokosch HU, Rauh M, Rank CM, Zierk J. refineR: a novel algorithm for reference interval estimation from real-world data. Sci Rep. 2021;11:16023. doi:10.1038/s41598-021-95301-2
- Wosniok W, Haeckel R. A new indirect estimation of reference intervals: truncated minimum chi-square (TMC) approach. Clin Chem Lab Med. 2019;57(12):1933–1947. doi:10.1515/cclm-2018-1341
- Meyer A, Müller R, Hoffmann M, Skadberg Ø, Ladang A, Dieplinger B, et al. Comparison of three indirect methods for verification and validation of reference intervals at eight medical laboratories: a European multicenter study. J Lab Med. 2023;47(4):155–163. doi:10.1515/labmed-2023-0042
- Dirks NF, den Elzen WPJ, Hillebrand JJ, Jansen HI, ten Boekel E, Brinkman J, et al. Should we depend on reference intervals from manufacturer package inserts? Comparing TSH and FT4 reference intervals from four manufacturers with results from modern indirect methods and the direct method. Clin Chem Lab Med. 2024;62(7):1352–1361. doi:10.1515/cclm-2023-1237
- Beck M, Dufey F, Ammer T, Schützenmeister A, Zierk J, Rank CM, et al. VeRUS: verification of reference intervals based on the uncertainty of sampling. Clin Chem Lab Med. 2026;64(3):688–697 (publicerad digitalt 2025). doi:10.1515/cclm-2025-0728
- Styrelsen för ackreditering och teknisk kontroll (Swedac). Styrelsen för ackreditering och teknisk kontrolls föreskrifter och allmänna råd om ackreditering. STAFS 2020:1 i konsoliderad lydelse, uppdaterad 2026-10-01 med ändringar till och med STAFS 2026:3 [Internet] [citerad 2026-10-02]. Tillgänglig från: https://regelverk.swedac.se/foreskrifter/swedac/stafs-2020-1-konsol.html
- Styrelsen för ackreditering och teknisk kontroll (Swedac). Medicinsk diagnostik [Internet] [citerad 2026-10-02]. Tillgänglig från: https://www.swedac.se/amnesomraden/medicinskdiagnostik/
- International Organization for Standardization. ISO 15189:2022. Medical laboratories – Requirements for quality and competence [katalogpost, citerad 2026-10-02]. Tillgänglig från: https://www.iso.org/standard/76677.html
- PJLA. LF-56-15189-2022, Rev. 1 (december 2023): offentlig checklista för bedömning mot ISO 15189:2022, avsnitt 7.3.5, tryckt s. 17 [Internet] [citerad 2026-10-02]. Tillgänglig från: https://www.pjlabs.com/downloads/LF-56-15189-2022.pdf
- Holmes DT, Buhr KA. Widespread incorrect implementation of the Hoffmann method, the correct approach, and modern alternatives. Am J Clin Pathol. 2019;151(3):328–336 (publicerad digitalt december 2018). doi:10.1093/ajcp/aqy149
- Zierk J, Arzideh F, Kapsner LA, Prokosch HU, Metzler M, Rauh M. Reference interval estimation from mixed distributions using truncation points and the Kolmogorov-Smirnov distance (kosmic). Sci Rep. 2020;10:1704. doi:10.1038/s41598-020-58749-2
- Hoffmann G, Klawitter S, Trulson I, Adler J, Holdenrieder S, Klawonn F. A novel tool for the rapid and transparent verification of reference intervals in clinical laboratories. J Clin Med. 2024;13(15):4397. doi:10.3390/jcm13154397
Källor och tolkningar
Riktlinjer och kommittéutlåtanden. Metodråden för direkt etablering och överföring kommer från CLSI EP28-A3c [1], med hänvisningar till respektive avsnitt. CLSI:s produktsida anger dokumentets status efter återbekräftelsen 2020. EP28IG [2] är en separat implementeringsguide och används här som bibliografisk orientering. Rekommendationerna om indirekta metoder hämtas från IFCC C-RIDL:s kommittéutlåtande från 2019 [3].
ISO och svensk ackreditering. Beskrivningen av ISO 15189:2022 §7.3.5 bygger på PJLA:s offentliga checklista [17], tryckt s. 17. Checklistan är en sekundär återgivning av standardkraven och inget svenskt regelverk. Uppgifterna om vad punkten inte föreskriver gäller §7.3.5 i denna återgivning. ISO:s katalogpost [16] anger standardens titel och utgåva. Hänvisningarna till STAFS 2020:1 [14] avser §1, §3 och §9 i Swedacs konsoliderade lydelse, uppdaterad 2026-10-01 med STAFS 2026:3. Swedacs ämnessida [15] anger vilka standarder och föreskrifter som tillämpas för klinisk kemi.
Metodkällor. Hoffmann- och Bhattacharya-metoderna beskrivs efter Holmes och Buhr [18] och IFCC-gruppens rekommendationer [3]. TML beskrivs efter IFCC-gruppens rekommendationer [3] och metodredogörelsen i RIbench [8]. Beskrivningarna av kosmic [19], refineR [9] och reflimR [20] bygger på respektive metodartikel. TMC beskrivs utifrån originalartikelns sammanfattning och metodavsnitt [10], med introduktionen i [9] som ytterligare stöd. Beskrivningen avser den publicerade metoden. reflimR-beskrivningen gäller version 1.0.6 enligt [20]; studien i [11] gäller föregångaren RefLim.
Forskningsunderlag. Översikten av Olthof m.fl. [4] ger bakgrund om bland annat urval och censurerade resultat. Den specificerade 20+20-regeln hämtas från CLSI [1]. RIbench [8] är en simuleringsstudie, medan [9], [10], [13], [19] och [20] beskriver metoder utvecklade av författarna själva. Jämförelsen i [11] använder data från åtta laboratorier men saknar kända sanna percentiler i dessa data; de tre första författarna är knutna till Abbott. Studien i [12] jämför direkta och indirekta resultat för två tyreoideaanalyser och fyra plattformar; flera författare ingår även i [4]. Uppgifterna om huvudresultaten i [11–13] hämtas från originalartiklarnas sammanfattningar och förlagssidor.
Egna slutsatser och exempel. Att ett smalt KI inte visar ett representativt urval, att ett modellbaserat KI inte fångar modellfel, att ett för brett indirekt intervall kan undgå en 20-personerskontroll och att flaggningsandelen påverkas av patientmixen är statistiska tolkningar av [1, 3, 8, 11]. Avsnitten om anpassningsområde, trunkering, transformation och sannolikhetsskala är egna statistiska förklaringar av metodbeskrivningarna, och figur 1–3 är syntetiska modeller som inte har tagits fram med någon namngiven metod eller med patientdata. Att ett icke-patologiskt resultat inte innebär en frisk person och att komponentandelen inte är en prevalens är begreppsliga förtydliganden. Metodjämförelsen och känslighetsanalysen i exempel 3, test av visning och flaggning i laboratoriedatasystemet och en lokalt fastställd granskningsfrekvens är praktiska förslag. Samtliga räkneexempel och deras mätvärden är syntetiska.